CSC 580: Principles of Machine Learning
Supervised learning
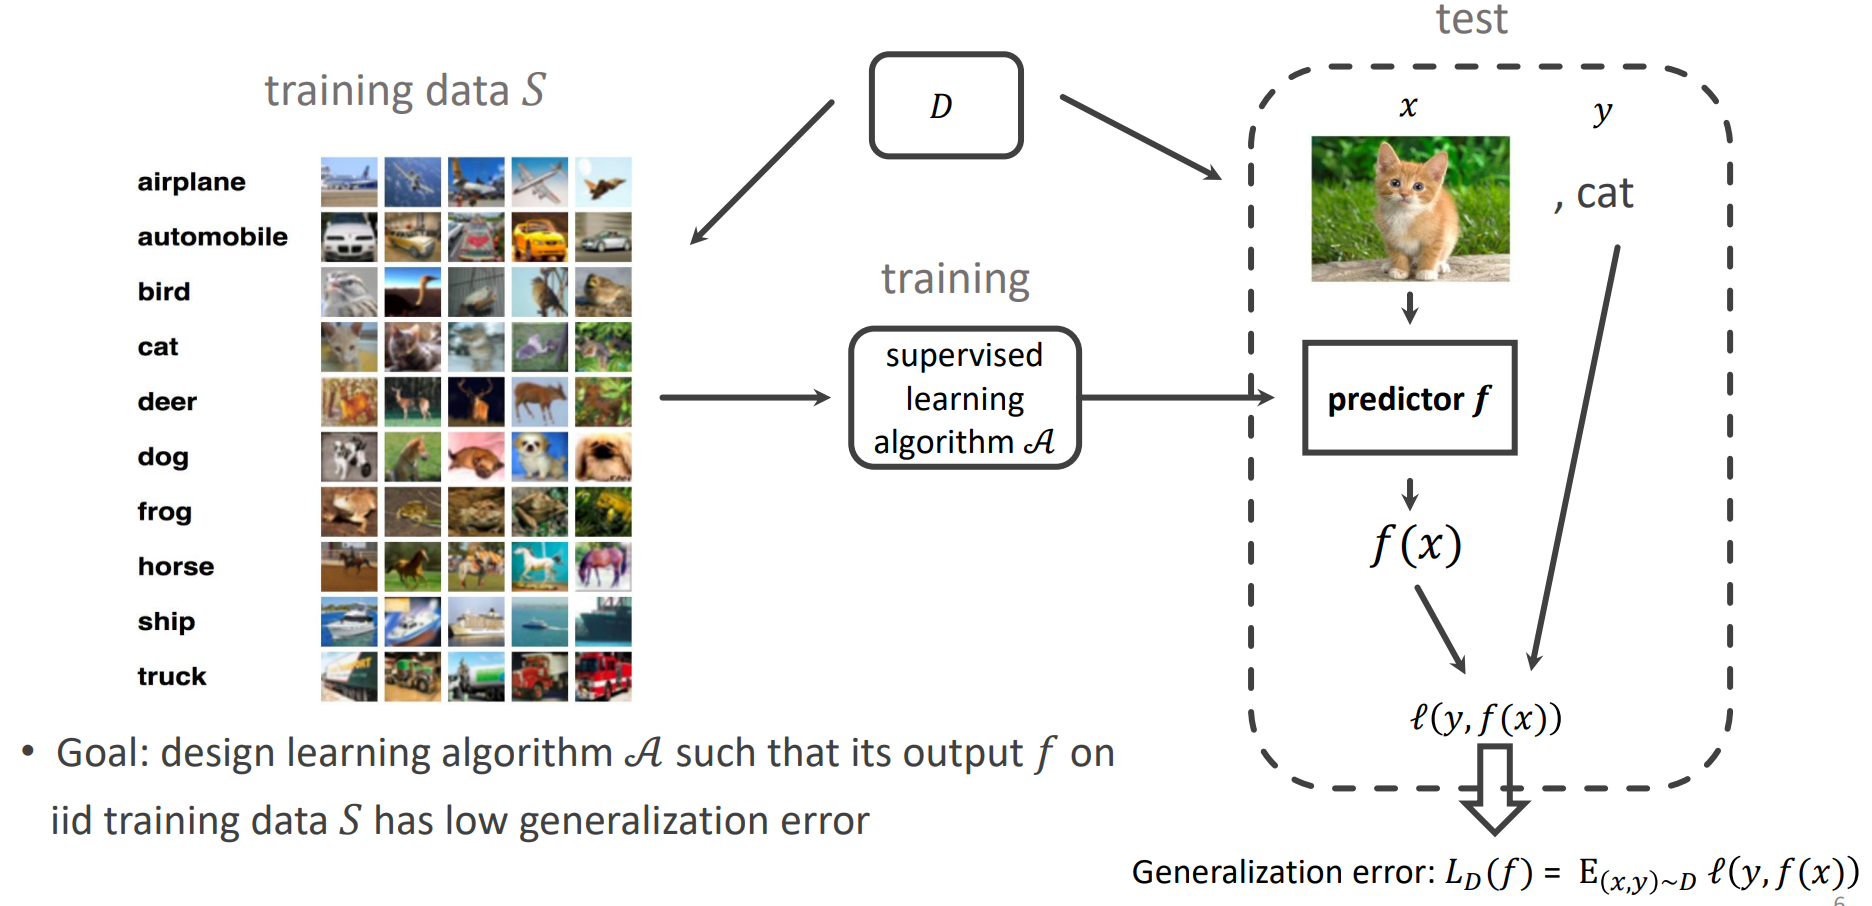
Generalization:在有限的数据集更好的拟合这个分布
补齐 Training 和 Evaluation 之间的 Gap
Decision Trees
Formal Setup
Training / Test Data: datasets comprised of labeled examples: pairs of (feature, label)
Draw: Training and Test Data are drawn independently (IID) from the same data generating distribution $D$
IID: independent and identically distributed,独立,且同分布地在 $D$ 中提取,function 在 test data 上才有泛化能力。
Scenario
- classification: [picture of a cat] $\overset{\texttt{function}}\Longrightarrow$ cat (label)
- regression: 2000 sqft $\overset{\texttt{function}}\Longrightarrow$ \$830K (value)
Measure
Loss function $\ell(y, \hat{y})$: measuring the prediction quality with respect to ground truth label.
Excample: $I(y\neq \hat y),(y-y’)^2,|y-y’|,\ldots$
Definition
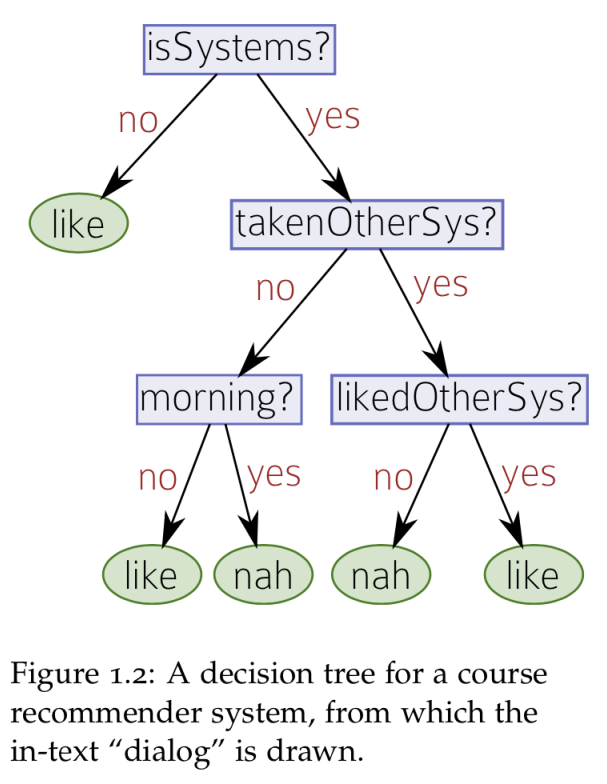
假设有 $d$ 维数据,在每个节点处都选择一个维度数据进行切分。
Key advantage: Intepretability.
理解:内部的机制与决策过程透明,用户可以观察决策过程进行微调,但模型过大是否意味着仍然无法在微观上进行调整?
Error
The training data $S = \{(x_i, y_i)\}_{i=1}^m\subseteq D$
Given a predictor $f$, its training error $L_S(f) = \mathrm{E}_{(x,y)\sim S}\, \ell(y, f(x)) = \frac{1}{m} \sum_{i=1}^m \ell(y_i, f(x_i))$
- 经验风险最小化(Empirical Risk Minimization, ERM)
$f$ with low $L_S(f)$ (训练误差 Training Error) $\Rightarrow f$ with low $L_D(f)$ (泛化误差 Generalization Error)
Training
Split
对于每个 internal node 都会对它所控制的 data 集合进行划分,回答为 NO 的交给左儿子继续 split,回答为 YES 的交给右儿子继续 split。那么对于一个 feature $f$ 会对每条 data 进行一个回答 $x_f$,根据 data 中 $x$ 种类不同,有不同的回答方式。
- $x_f\in \{0,1\}$:$x_f=0$ ?
- $x_f\in \{0,1,2,\cdots,C\}$:$x_f\in \{i_1,i_2,\ldots,i_k\}$?
- $x_f\in \mathbb{R}$:$x_f\leq z$?
Score
对于一个 feature $f$,它在 data $S$ 下的 score 定义为:
若拆成条件概率,那么前半部分为 Purity measure。
理解:判断 YES 的部分数据的纯度,加上判断 NO 的部分数据的纯度,两者按权重相加
Build
递归建决策树时,分为 $\mathtt{data,remaining features}$。
- 如果当前节点需要决策的 data 集合具有相同的 label,直接返回对应 label。
- 如果当前可判断的 features 为 empty,直接返回概率最大的 label。
- 否则,选择 $\max score(f)$ 的 feature $f$,以它进行切分。
- 判断为 NO 的 data 递归左儿子;
- 判断为 YES 的递归右儿子。
由于 split 中的参数可以改变,所以一个 feature 在一条根链中可以用来划分好多次,那么调一下划分次数防止过拟合,又有很好的泛化效果,这部分是同维度的衡量吗。
Score (imporved)
如何设计 score 本质上是 design a measure of informativeness of $f$ and maximize it.
采用 reduces uncertainty (“chaoticness”) 程度来衡量。
对于 classification 任务,对于一个 data 集合假设属于第 $k$ 类的比例为 $p_k$。
- 分类误差 (Classification error): $u(S) = 1 - \max_k p_k$
- 基尼指数 (Gini index): $u(S) = 1 - \sum_k p_k^2$
- 信息熵 (Entropy): $u(S) = \sum_k p_k \log_2(\frac{1}{p_k})$
Generalized Score: feature $h$ 的好坏,取决于它能减少多少不确定性(即信息增益)。
$Score(h, S) = u(S) - (p_L \cdot u(S_L) + p_R \cdot u(S_R))$
Issues
错误的想法: 任意一个 feature 都不会减少 uncertainty 就 return。
反例 (also Underfitting):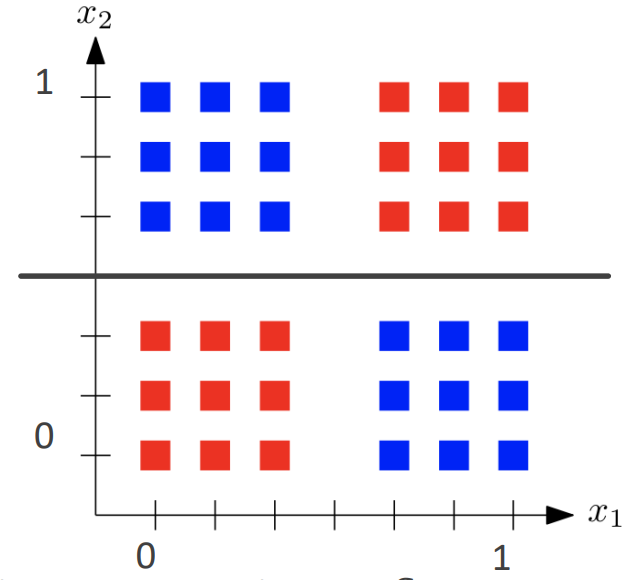
Overfitting:决策树特别大导致过拟合。
例子: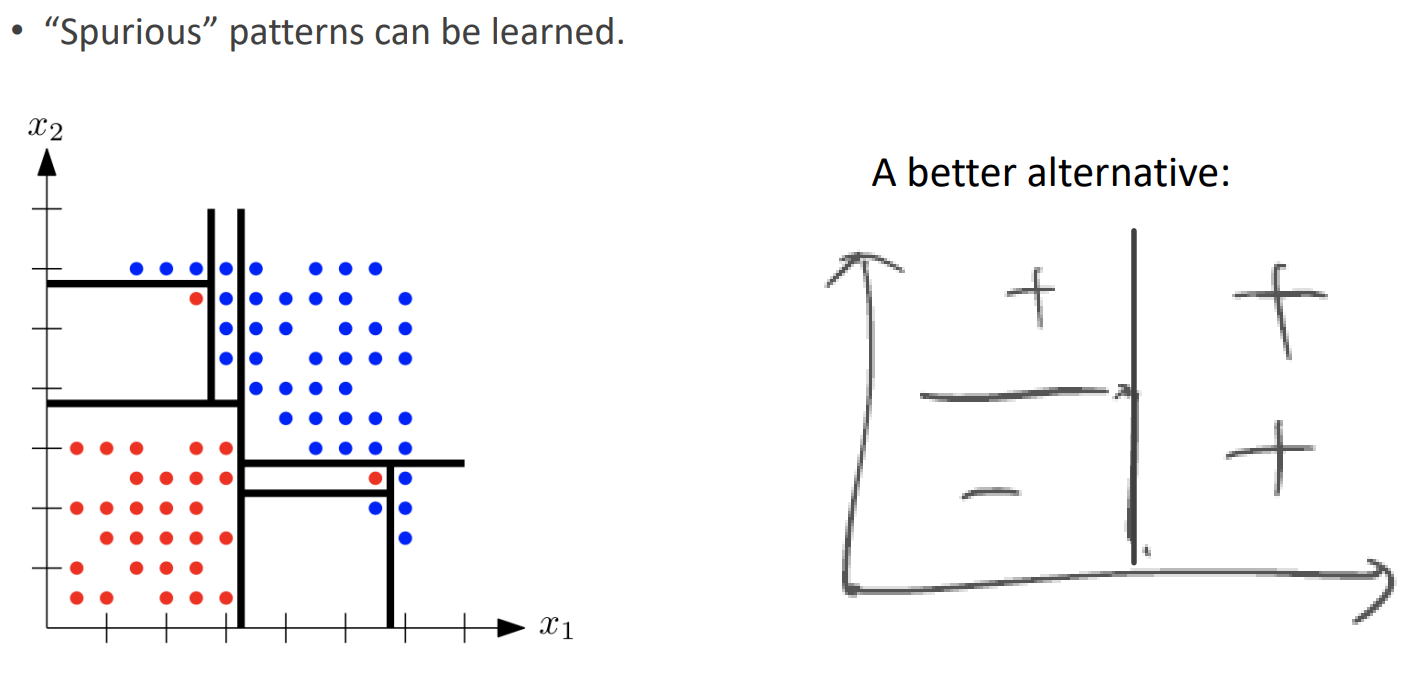
所以我们需要在 Underfitting 和 Overfitting 之间找到一个 balance point。
Limits of Learning
Bayes optimal classifier
目标是在数据分布 $D$ 下最优化 $L_D(f) = \mathbb{E}_{(x,y)\sim D}[l(y,f(x))]$,在离散的情况下审视该问题,对于一个离散的数据分布,分类器 $f$ 在每种 $x$ 值的所有可能中选取概率最大的那个,能使得 $L_D(f)$ 最小,即预测失败的期望惩罚最小。容易推广到连续的情况。
| $x=1$ | $x=2$ | $x=3$ | |
|---|---|---|---|
| $y=-1$ | 0.2 | 0.2 | 0.15 |
| $y=+1$ | 0.1 | 0.3 | 0.05 |
最优分类器一定是 Bayes optimal classifier,it defined as
我觉得这里思考的另一要点是去思考实际应用中,生产数据可能不符合预期条件,所以要对其进行一定的分析。
同时这个地方也能说明,分类器的最优策略一定是确定性回答,因为加权平均数会 $\geq$ 最小值 $\times 1$。
Noise
Limited feature representation: feature 不足以区分。
Feature noise: 传感器故障等,导致 feature 失真。
Label noise: 标注者恶意破坏,导致 label 不可信。
Construct model using test data
将数据切分,保留一部分未参与训练的数据作为 Test data。
根据大数定律 (Law of large numbers),由于模型 $\hat f$ 和 Test data 完全独立,所以 $\hat f$ 可以当作完全无关的函数。
那么当测试集足够大即 $L_{test}\to \infty$ 时 $L_{test}(\hat{f}) \xrightarrow{P} L_D(\hat{f}) $,Training Error 收敛到真实的 Generalization Error。
因为随机变量 $Z_i=l(y_i, \hat f(x_i))$ 是相互独立且 IID 选取的。
训练集足够大即 $S_{train}\to \infty$ 时却不能成立 $L_{train}(\hat{f}) \xrightarrow{P} L_D(\hat{f}) $。
考虑一个根据气压值进行晴雨预测问题,如果 $\hat f$ 采用查表法记住了所有样本(这里假设输入气压值是连续的,即不会出现相同气压的样本),未在表中的随机回答。由于它记住了所有训练集所以 $L_{train}(\hat f)=0$,但由于它记不住所有 feature,或者本身有一定概率性波动,所以 $L_D>0$。
在这个例子中,为什么不满足大数定律。首先由于 $\hat f$ 和整个训练集相关,所以随机变量 $Z_i=l(y_i, \hat f(x_i))$ 之间不独立。此外,它会最小化在训练集 $S_{train}$ 上的表现(经验风险最小化),所以这里并不成立。
模型复杂度和数据量大小的 trade-off。
模型构建的任何环节都不能依赖测试集。
Terminologies
模型/预测器(Model / Predictor $\hat{f}$):具体的预测函数,通常属于某个假设空间(Model Class $\mathcal{F}$),如决策树类、线性分类器类。
参数(Parameters):模型内部学习出来的数值/结构。
- 决策树:树的分裂结构、节点判断条件、叶子节点的预测类别。
- 线性分类器:各特征的权重系数 $w_1, \dots, w_m$ 和偏置。
超参数(Hyperparameters):控制学习算法本身行为的外部配置。不可微的,所以它不能作为梯度进行调整。
- 例如:限制决策树的最大深度 $h$、正则化系数等。
- 超参数的调整直接决定了模型是倾向于欠拟合还是过拟合。
Select hyperparameters
Validation set
Example: 在决策树中选取最优的超参数树高 $h$。选在 Test Data 上最优的 $h$ 会过拟合,并且违背了模型构建不能依赖 Test Data 的原则。
Solution: 再区分出一个集合 $S_{val}$ 验证集 (validation set),在不同 $h$ 在 traning set $S_{train}$ 训出来不同模型,选择在validation set 上表现最好的 hyperparameters $h$,最后在 test set $S_{test}$ 上进行模型评估。
这里可能会使得训练出来的模型只在验证集上表现最优,但在全局不能泛化。但有 Hoeffding 不等式与联合界(Union Bound) 的泛化误差界存在。
暂时先理解为这里需要 hyperparameters 比较少,validation set 比较大。
N-fold Cross Validation
1 | Run 1: [ Val ] [ Train ] [ Train ] [ Train ] [ Train ] -> 得到误差 e_{h,1} |
当数据量比较少的时候,用来调优模型的数据可以重复利用,轮流做 validation set。
- 先将所有数据分出 Training Data 和 Test Data,此后 Test Data 完全隔离,和训练无关。
- 对每个超参数具体取值进行评估:将 Traning Data 分为 $N$ 组,第 $i$ 次训练抽出第 $i$ 组作为 validation set,算出所有训练的 Error 平均值。
For hyperparameter $h \in \{1, \dots, H\}$
- For $k \in \{1, \dots, K\}$
- train $f$ with $S \setminus \text{fold}_k$
- measure error rate $e_{h,k}$ of $f$ on $\text{fold}_k$
- Compute the average error of the above: $E_h = \frac{1}{K} \sum_{k=1}^{K} e_{h,k}$
Choose $\hat{h} = \arg\min_h E_h$
Train $\hat{f}$ using $S$ (all training examples) with hyperparameter $\hat{h}$
k-Nearest Neighbors, k-NN
核心 idea 是:如果能在 Training Data 中找到一个 feature 尽可能相似的,那么依据它的答案回答即可;对于 Regression 可以求 Average (various)。
有可能会被一些孤立的噪声点影响过大,所以考虑选取距离 (distance or similarity) 的 $k$ 个邻居之后进行摩尔投票法得到分类。
Feature Encoding:
多类别转换:
- 错误:Red, Blue, Green, Pink $\Longrightarrow$ $1,2,3,4$,引入了新的偏序和距离。
- 正确:Red, Blue, Green, Pink $\Longrightarrow$ $(1,0,0,0),(0,1,0,0),(0,0,1,0),(0,0,0,1)$,任意两类相对相同。
Variations
距离加权:邻居可以进行距离加权,设计权重 $w_i \propto \exp(-\beta \cdot d(x, x_i))$ 或 $w_i \propto \frac{1}{1 + d(x, x_i)^\beta}$,利用 $\beta$ 值调整距离权重衰减速度。
类别概率估计:$\hat{P}(Y=y\vert{}x) = \frac{1}{k} \sum_{i \in N(x)} \mathbb{I}\{y_i = y\}$ 进行置信度计算,不达标时交给人工处理。
Issues
Scaling
不同的特征由于量纲问题,导致影响程度不一样,所以需要 Feature Standardization 特征标准化
Interference from Irrelevant Features
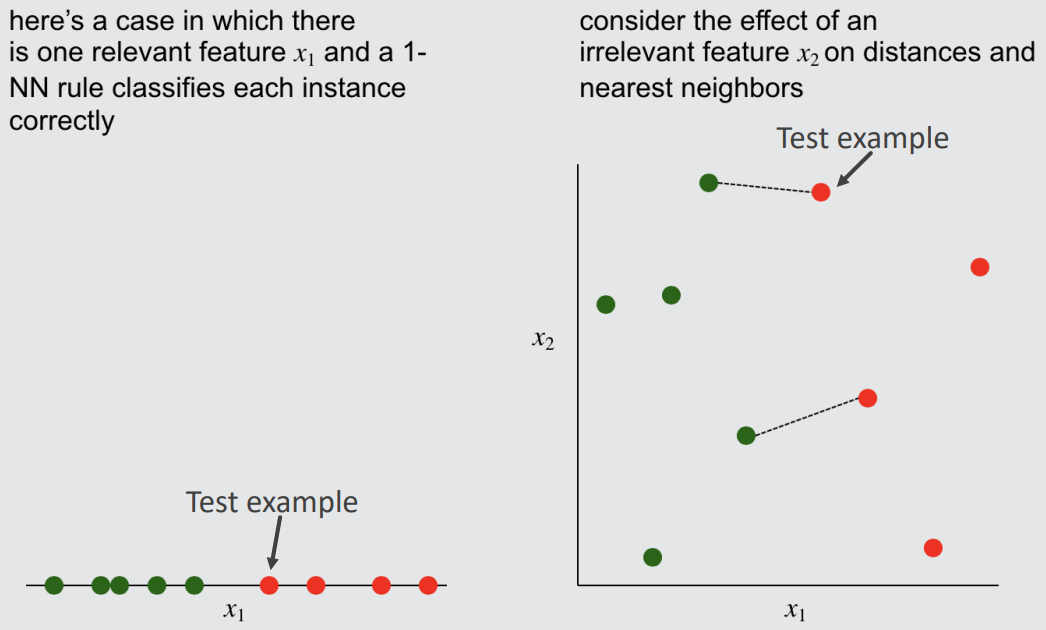
在图示数据中,仅靠 $x_1$ 已经可以优秀分类,引入 $x_2$ 这一维无关特征会导致影响。
Dimension Volume
引入过多维度会使得体积总数指数级增加,导致样本点在绝对意义上比较稀疏。
Distance Weirdness
在 $D$ 维空间下的半径 $r=1$ 的超球中,大小为 $\epsilon$ 的薄壳体积为 $1-(1-\epsilon)^D$,这意味着当 $D$ 过大时,$\epsilon$ 多小,体积占比依然很大。这意味着如果样本点数量正比于区域的体积,那么很大一部分样本点都会聚集在相近的距离,使得距离度量效果差。
Select k
$k=1$: Traning error = 0,过度适应每一个数据点(包括噪声),导致 Overfitting。
$k=m$(样本总数):对任何输入都输出训练集中占比最多的类别,完全丢失局部特征,导致 Underfitting。
可以利用 Validation Set 和交叉验证挑选 $k$。
Unsupervised Learning
K-Means
流程:逐步迭代。
初始化(Initialization):随机选择 $k$ 个初始质心 $\mu_1, \dots, \mu_k$。
交替迭代直至收敛(Until Convergence):
- 步骤 A:簇分配(Cluster Assignment):遍历每个样本点,将其分配给距离最近的质心所在簇:
- 步骤 B:重新计算质心(Recompute Centroids):对每个簇,将质心更新为该簇内所有样本点的均值:
考虑下式在步骤 $A$ 中可能不变或者变小,步骤 B 中如果没有收敛那么一定会变小,而 $J\geq 0$ 且方案数是有限的,所以一定收敛。问题在于可能收敛到局部最优解,而非全局最优解。可以采用多次重启,或者在初始时将质心定得远一些。
Linear Classification; Perceptron
线性分类器与感知机。
Linear Classification
预设一组权重向量 $w$,对于特征向量 $x$,衡量 $w\cdot x$ 的正负,决定结果是 $+1$ 还是 $-1$。例如垃圾邮件判定,对于 free 等次具有正权重,对于 lecture 等学术用词具有负权重。
它的设计方法 idea 来源于生物神经元模型,其由前驱神经元的突触激活强度加权求和,决定是否激活当前神经元。本质上都是在实现线性阈值函数(Linear Threshold Function)$h_w(x) = \text{sign}(\langle w, x \rangle)$。
Geometric View:
- 对于齐次的情况 $h_w(x) = \text{sign}(\langle w, x \rangle)$ 是一个过原点的超平面,将所有数据点分为正方向均 $y=+1$ 和反方向均 $y=-1$。
- 对于不齐次的情况 $h_{w,b}(x) = \text{sign}(\langle w, x \rangle + b)$ 可以通过增加一维表示常数项 令 $\tilde{w} = (w, b) \in \mathbb{R}^{d+1}$,$\tilde{x} = (x, 1) \in \mathbb{R}^{d+1}$ 得到 $h_{w,b}(x) = \text{sign}(\langle \tilde{w}, \tilde{x} \rangle)$。
注意这里不齐次的情况,$b$ 并不是 feature,还是一个需要调出来的 parameter,所以它应当属于 $\tilde w$。
Perceptron Algorithm
Rosenblatt 1958
Initialize $w_1 \leftarrow (0, \dots, 0)$
每轮迭代:
For $t = 1, 2, \dots, n$:
Process example $x_t \in \mathbb{R}^d$
Calculate classification score $a_t = w_t \cdot x_t$
Update:
- if $y_t a_t > 0$: $w_{t+1} \leftarrow w_t$;
- otherwise: $w_{t+1} \leftarrow w_t + y_t x_t$.
PS: 此处相当于对 Perceptron Loss 的一个梯度下降。
这样可以使得每轮迭代之后,权重向量 $w$ 向失败的向量 $x$ 方向旋转一下
对于 Perceptron for Non-homogeneous Classifiers 非齐次感知机,本质上和加一维表示常数项一样。
Issues
Hyperparameter
对迭代轮数 MaxIter,训练较少会导致 Underfitting,训练较多会导致 Overfitting,需要进行 trade-off。
Data Shuffling
Perception Algorithm 和数据排列关系有关,如果数据呈现某种规律,例如 +++++...-----... 会导致模型不断正方向调整再负方向调整剧烈震荡,所以需要在一开始的时候对所有数据进行随机打乱。
Convergence
数据集 $S$ 是线性可分 (Separable) 的,当且仅当存在一个权重向量 $w^$,使得对所有样本 $(x, y) \in S$,均满足:$y \langle w^, x \rangle > 0$,即存在一个超平面 $\langle w^*, x \rangle = 0$ 可以区分所有样本点。
Theorem: Separable $\Longleftrightarrow$ Converge
Converge $\Longrightarrow$ Separable 是显然的,其逆否命题成立。在后文会证明 Separable $\Longrightarrow$ Converge。
Margin
衡量一个数据集在线性分类下的“容易程度”以及决策超平面的“容错空间/摆动余量(Wiggle room)”
Margin of a linear classifier $w$ on $S$:
Margin of dataset $S$:
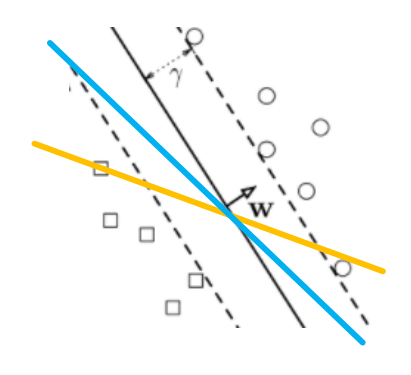
在几何上相当于,在所有 Separable 的单位法向量 $w$ 中,找到使得《距离超平面的最近样本点距离》最大的那个间隔 $\gamma$(即图中的虚线带宽度)。
Perceptron Convergence Theorem
Novikoff 1962
Assume:
$\text{margin}(S) \ge \gamma$, i.e., there exists $w^$ with $\Vert{}w^\Vert{}_2 = 1$ such that $y \langle w^, x \rangle \ge \gamma$ for all $(x, y) \in S$,即单位法向量 $w^$ 可以区分所有正侧反侧的样本点。
For all $(x, y) \in S$, $\Vert{}x\Vert{}_2 \le R$
Proof:
由于每次调整后 $w$ 会加上 $x$,而 $\langle w^*,x\rangle$ 存在下界,$\Vert{}x\Vert{}_2 \le R$ 存在上界,那么考察一下上下界能缩紧卡住 $w$,从而证明收敛。
令 $w^{(k)}$ 表示第 $k$ 次调整之后的 $w$:
- $\langle w^{(k)},w^\rangle=\langle w^{(k-1)}+yx,w^\rangle\geq \langle w^{(k-1)},w^\rangle+\gamma$,其中 $\langle yx,w^\rangle \geq \gamma$。
- $\Vert{}w^{(k)}\Vert{}_2=\Vert{}w^{(k-1)}+yx\Vert{}_2\leq \Vert{}w^{(k-1)}\Vert{}_2+R$
Therefore, $\langle w^{(k)},w^*\rangle\geq k\gamma$ and $\Vert{}w^{(k)}\Vert{}_2\leq \sqrt k$
在这里,利用 mistake 次数来 bound ,所以令 $M=#\text{mistake}$,则此时
$\langle w_{n},w^*\rangle\geq M\gamma$ ; $\Vert{}w^{(k)}\Vert{}_2\leq \sqrt M$
by Cauchy-Schwarz, $\langle w_{n},w^\rangle\leq \Vert{}w_n\Vert{}\cdot \Vert{}w^\Vert{}=\Vert{}w_n\Vert{}$ 即 $M\gamma \leq \sqrt M$
$\Longrightarrow M\leq 1/\gamma^2$
Practical versions
Voting Perceptron
由于最近的更新有可能破坏掉之前已经训好的模型,所以在最终预测的时候将所有模型的预测结果进行加权投票。假设更新 $K$ 次,所有模型分别是 $w_0,w_1,\ldots w_K$,其中令 $c_k$ 表示第 $k$ 次模型经过了几步才被 check 失败进行调整。那么对一个 $x$ 的预测结果 $h(x)$ 应当是:
即在预测的时候进行加权投票。
Averaged Perceptron
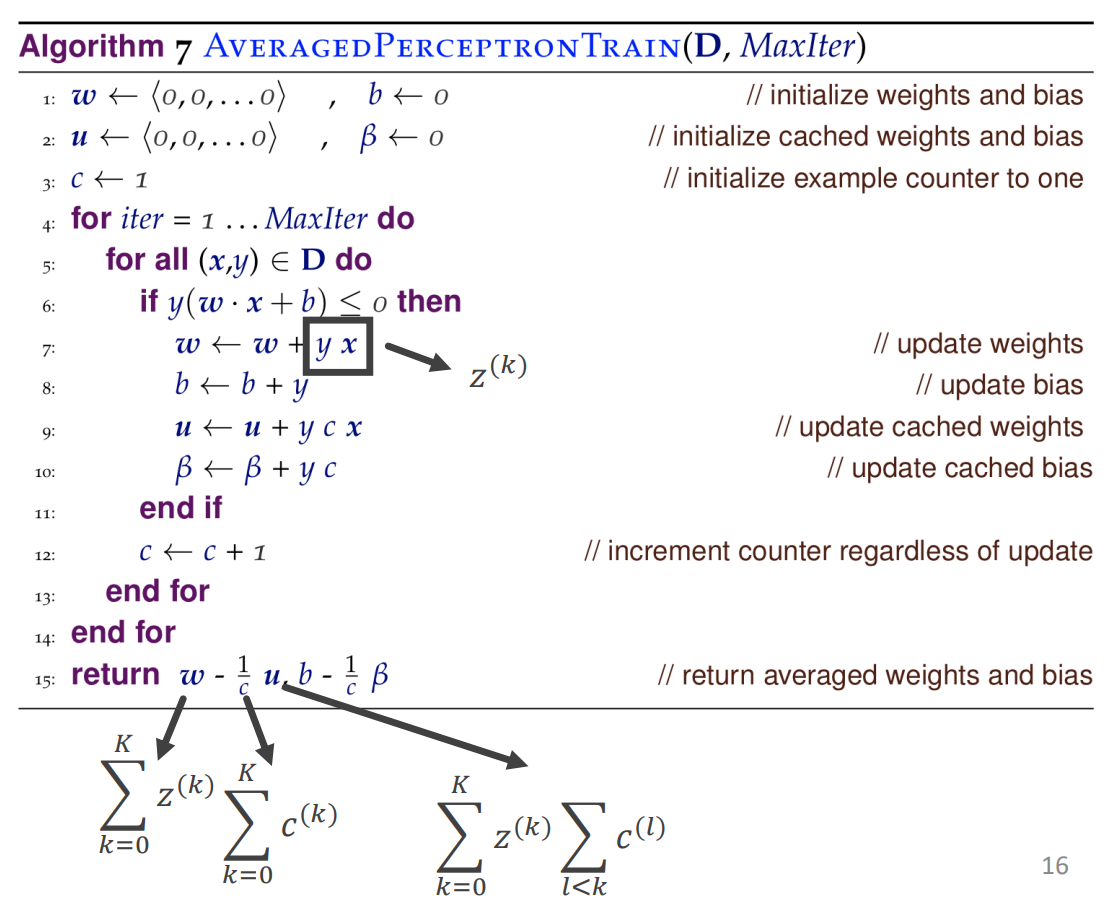
Voting Perceptron 对于一个 $x$ 的回答需要查询所有版本模型 $w$,那么能不能将所有模型取平均,作为最终模型来预测,这样只需要作一次点积。
$h(x) = \operatorname{sign}(\langle\overline{w}, x\rangle)$, where $\overline{w} = \frac{1}{T}\sum_t w_t = \frac{1}{\sum_{k=0}^K c^{(k)}} \sum_{k=0}^K c^{(k)} w^{(k)}$ is the averaged predictor。
等价于使用 $\operatorname{sign}\left(\left\langle \sum_{k=0}^K c^{(k)} w^{(k)}, x \right\rangle\right)$ 进行预测。
在实现上,由于 $w$ 的维度会特别大,$x$ 的维度会较小,所以在计算时可以用这个 trick:拆贡献,考虑第 $k$ 次错误时的改变量 $yx$,假设在第 $t_k$ 时刻发生,一共有 $T$ 时刻,那么它在最终的 model 中会出现 $(T-t_k)$ 次,其中只需要累加 $-t_kyx$,最终加上 $T\left(\sum yx\right)=T\cdot w_K$ 即可。这样子每次错误只需要遍历 $x$ 非零的维度。
Nonlinear Feature
同理,这里只是对 parameter 线性,也可以将实际 feature 作非线性组合加入到 parameter 中,例如 $x_1x_2,z^2$ 等。
Practical Considerations
The role of features in supervised learning
Irrelevant Features: 不相关的特征。
Redundant Features:给定 $f_1$ 时,$f_2$ 和 $y$ 几乎条件独立。$f_2$ 虽然有关,但是它是冗余的。
归一化方法:
- 中心化 (Centering):$x’_{i,f} = x_{i,f} - \mu_f \implies$ 新均值 $\mu’_f = 0$。
- 方差缩放 (Variance scaling / Z-score):$x’_{i,f} = x_{i,f}/\sigma_f \implies$ 新方差 $(\sigma’_f)^2 = 1$。
- 绝对极值缩放 (Absolute scaling):$x’_{i,f} = x_{i,f}/\max_i \vert{}x_{i,f}\vert{} \implies$ 映射到 $[-1, +1]$ 区间。
样本级归一化 (Example normalization):$x’_i = x_i / \Vert{}x_i\Vert{}$(常用于余弦相似度计算)。
Feature 非线性组合方法:
二次与多项式项:$x_j^2$ 捕捉单变量曲率,$x_j x_k$ 捕捉特征间的二阶交互;
- 单特征非线性映射:$\log(x_j), \sqrt{x_j}, \exp(x_j)$ 等;
- 指示函数(区间分箱):$\phi_m(x) = \mathbb{I}(L_m \le x_k < U_m)$(将连续数值离散化为分段常数函数)。
Classification metrics beyond error rate
传统机器学习以未加权训练错误率 $\sum \mathbb{I}(h(x_i) \ne y_i)$ 为损失函数。对于极端不平衡数据,分类器只要无脑将所有样本预测为“阴性”,错误率就只有 5%(准确率高达 95%),但对于癌症患者而言毫无价值。
- 重复采样:将正样本复制 $w = P(y=-1)/P(y=+1)$ 倍使得样本均衡;
- 重要性加权:为阳性样本赋予更高误判惩罚权重 $w_i = w$,最小化加权损失 $\sum w_i \mathbb{I}(h(x_i) \ne y_i)$
Confusion matrix
| predicted class actual class | positive | negative |
|---|---|---|
| positive | true positives ($\text{TP}$) | false positives ($\text{FP}$) |
| negative | false negatives ($\text{FN}$) | true negatives ($\text{TN}$) |
样本总量:$P = \text{TP} + \text{FN}, \quad N = \text{FP} + \text{TN}$
评价指标:
真正例率 (TPR / Recall / Sensitivity) $= \frac{TP}{TP+FN} = \frac{TP}{P}$(阳性患者中查出多少)。
真负例率 (TNR / Specificity) $= \frac{TN}{TN+FP} = \frac{TN}{N}$(健康人中排除多少)。
假正例率 (FPR / Type I Error) $= \frac{FP}{TN+FP} = \frac{FP}{N}$(误诊率)。
假负例率 (FNR / Type II Error) $= \frac{FN}{TP+FN} = \frac{FN}{P}$(漏诊率)。
精确率 (Precision) $= \frac{TP}{TP+FP}$(预测为阳性的人中有多少是真的阳性)。
ROC Curve
在二分类中,先计算一个实数分值 $c(x)$,再通过阈值 $t$ 截断来做硬判决:$h_t(x) = +1$ 当且仅当 $c(x) > t$。
比方说对于 Perceptron 可以选取到超平面的有符号距离;对于 Decision Tree 可以选取 example 最终落入的叶子中,正向 training example 的出现频率。
将样本按 $c(x)$ 降序排列后,每次遇到一个样本,对应修改 TPR 和 FPR 然后绘制点。得到 ROC Curve。
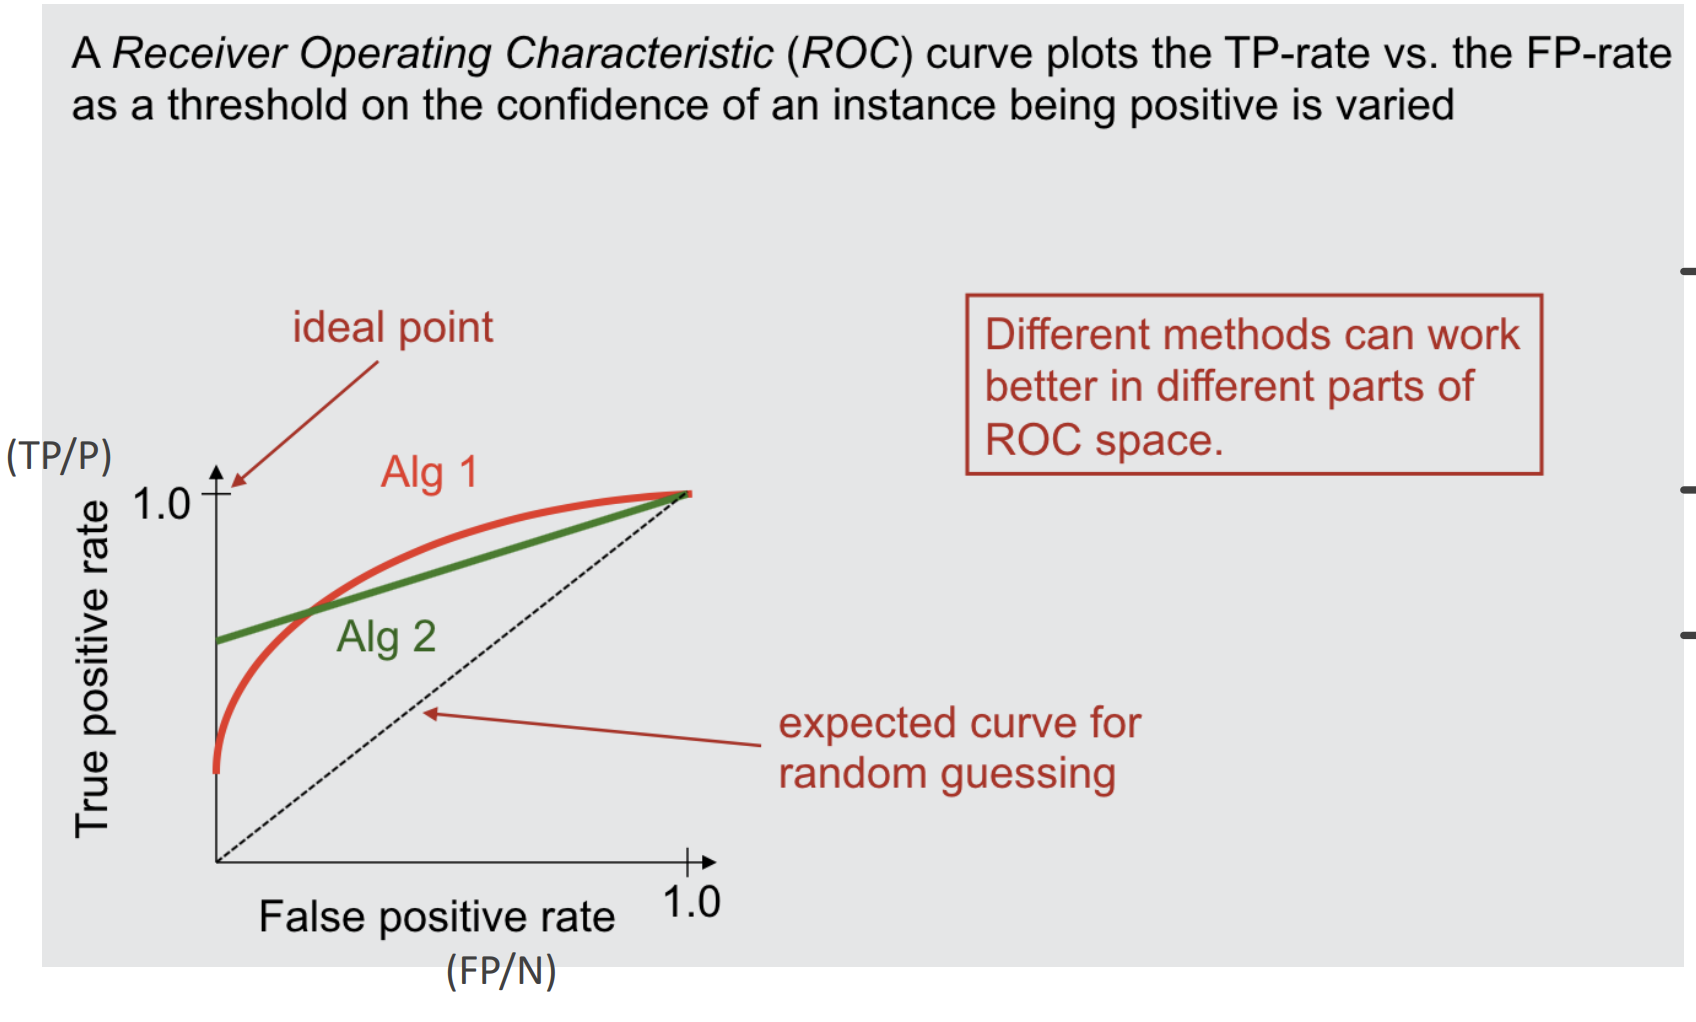
一个衡量模型强弱指标的参数:AUC,计算 ROC 曲线下的几何积分面积。
该计算公式等价于在横轴上作积分。
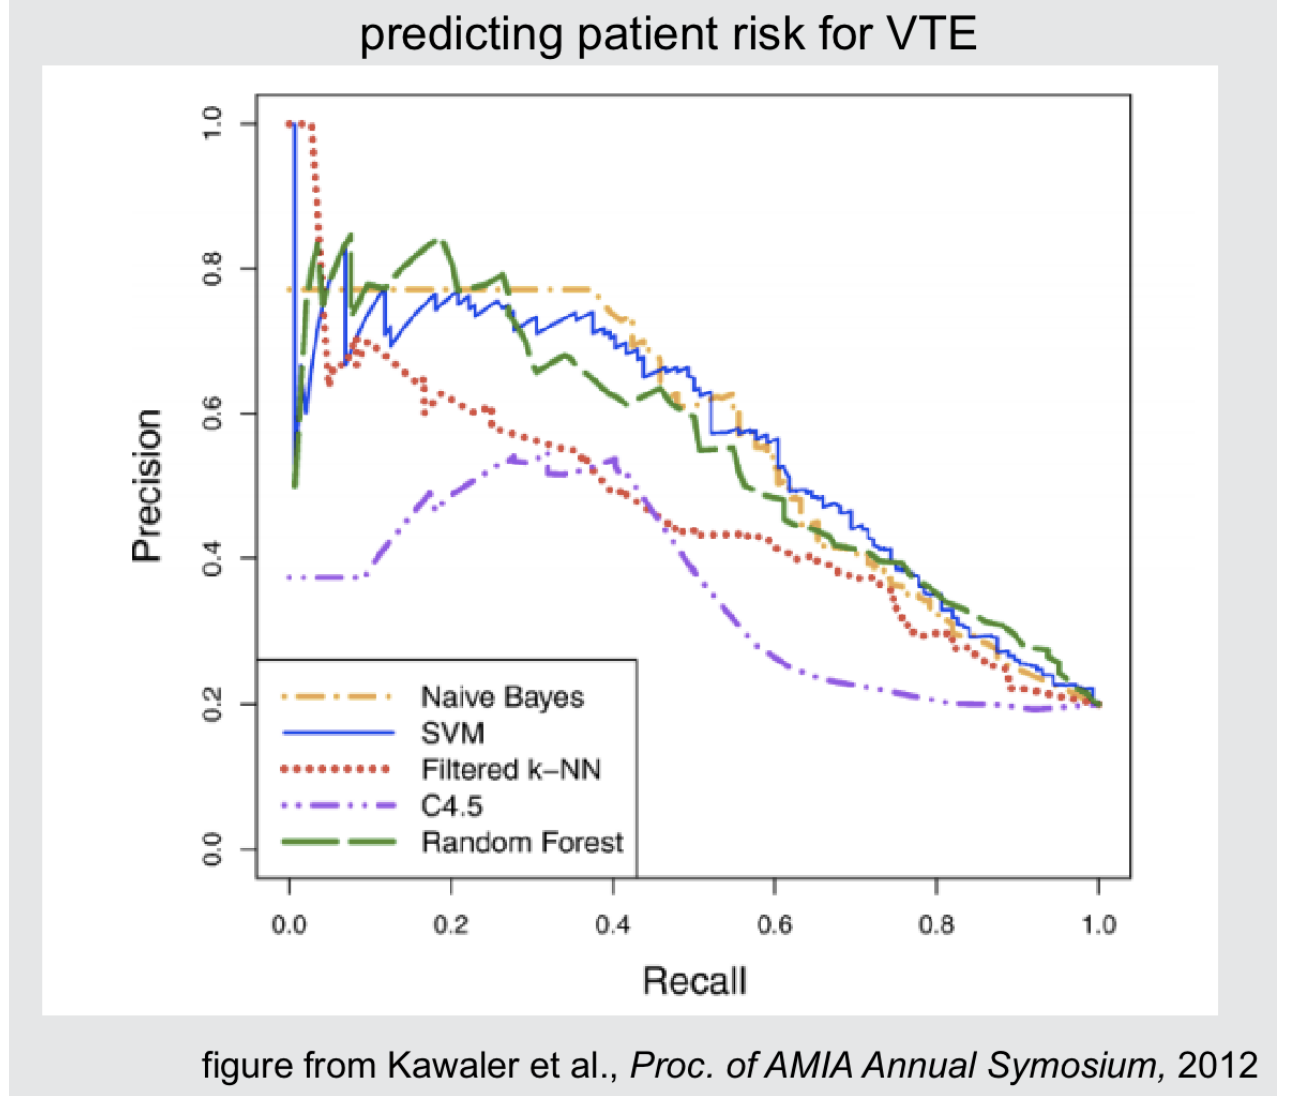
PR Curve
横轴为 Recall (TPR),纵轴为 Precision。理想目标点位于右上角 $(1.0, 1.0)$